
Eliminar el cuello de botella en el gobierno de la IA empresarial con Cloudera Agent Studio 3.0
Las empresas están acelerando el despliegue en producción de agentes de IA altamente valiosos y diferenciados. Pero los agentes más valiosos dependen de los datos sobre los que las organizaciones menos pueden permitirse perder el control: datos sensibles y propietarios.
Esto plantea un reto inmediato en materia de gobierno. En muchas arquitecturas tradicionales, los agentes tienen que sacar los datos del almacenamiento gestionado y trasladarlos a plataformas SaaS externas antes de poder utilizarlos. En el momento en que eso ocurre, las organizaciones pierden la capacidad de controlar los datos por completo desde su origen y se enfrentan a tres riesgos que se agravan entre sí:
Seguridad: Cada exportación crea una copia externa de datos sensibles, lo que amplía la superficie de ataque y obliga a los equipos a gestionar, aplicar parches y auditar por separado un conjunto de datos paralelo con respecto a su fuente de información fidedigna.
Rendimiento: el traslado de ida y vuelta de los datos a una plataforma externa introduce latencia y elimina las optimizaciones de consulta integradas en el almacenamiento gestionado, lo que hace que los agentes funcionen mucho más despacio de lo que permite la infraestructura subyacente.
Coste: extraer datos a gran escala a través de los perímetros de la nube aumenta los costes de salida, a menudo de forma impredecible, ya que las cargas de trabajo de los agentes consultan los datos repetidamente en lugar de solo una vez.
Los datos y la IA que necesitamos para generar un valor verdaderamente diferenciado suelen ser precisamente los que conllevan el mayor riesgo si salen de nuestro control. Los equipos de cumplimiento normativo y seguridad que evalúan precisamente estos riesgos se ven a menudo obligados a intervenir, deteniendo iniciativas prometedoras justo cuando superan la fase de prueba de concepto.
Las cinco barreras estructurales para llevar la IA a producción
En esencia, los flujos de trabajo agénticos (que combinan LLM con interfaces de herramientas, planificación estructurada de tareas y bucles de ejecución continuos) no pueden funcionar de forma segura en una infraestructura aislada. Necesitan acceso directo a recursos de computación para las bases de datos gestionadas. Cuando se ven obligadas a utilizar configuraciones fragmentadas que implican el traslado de datos, las organizaciones se topan con cinco obstáculos distintos:
Autonomía de tipo caja negra y responsabilidades de auditoría: las decisiones autónomas de varios pasos generan riesgos normativos. El registro estándar del sistema captura las llamadas de los endpoints, pero no recoge la planificación de tareas de los subagentes internos, las entradas y salidas específicas de la carga útil de las herramientas, ni la identidad del usuario autenticado detrás de cada paso.
Desviaciones en el gobierno entre equipos aislados: cuando los equipos de negocio crean prototipos visuales en herramientas SaaS no supervisadas mientras los ingenieros escriben scripts de orquestación personalizados en Python en entornos independientes, la arquitectura técnica se divide. Esta dualidad elude los controles de acceso centrales y provoca desviaciones en el gobierno.
Fragilidad de las instrucciones y reintentos de ejecución: los marcos de trabajo tradicionales de los agentes dan instrucciones a los modelos mediante indicaciones de texto no estructuradas. Cuando un LLM genera texto de formato libre en lugar de esquemas de carga útil estructurados, las cadenas de ejecución se rompen. Los reintentos del sistema consumen tokens de API adicionales, aumentan la latencia de las consultas y provocan fallos en las rutas de ejecución de varios pasos.
Costes de salida de datos de la nube e inflación de tokens: extraer conjuntos de datos operativos más allá de los perímetros de la nube hacia hosts externos genera costes recurrentes por salida de datos. Pasar contexto no estructurado y sin filtrar a las ventanas de contexto de los LLM externos aumenta el uso de tokens en cada consulta, lo que encarece el coste de inferencia por consulta sin mejorar la precisión del razonamiento.
Dependencia de las API y costes fijos de computación: Codificar de forma rígida la lógica de orquestación para usar API de modelos propietarios hace que las empresas queden sujetas a precios fijos de computación. Los equipos de infraestructura pierden la flexibilidad para dirigir las llamadas rutinarias a funciones a modelos locales con menos parámetros y de menor coste, mientras reservan las API de vanguardia de terceros para el razonamiento complejo.
Cómo ofrece Cloudera Agent Studio una ejecución gobernada
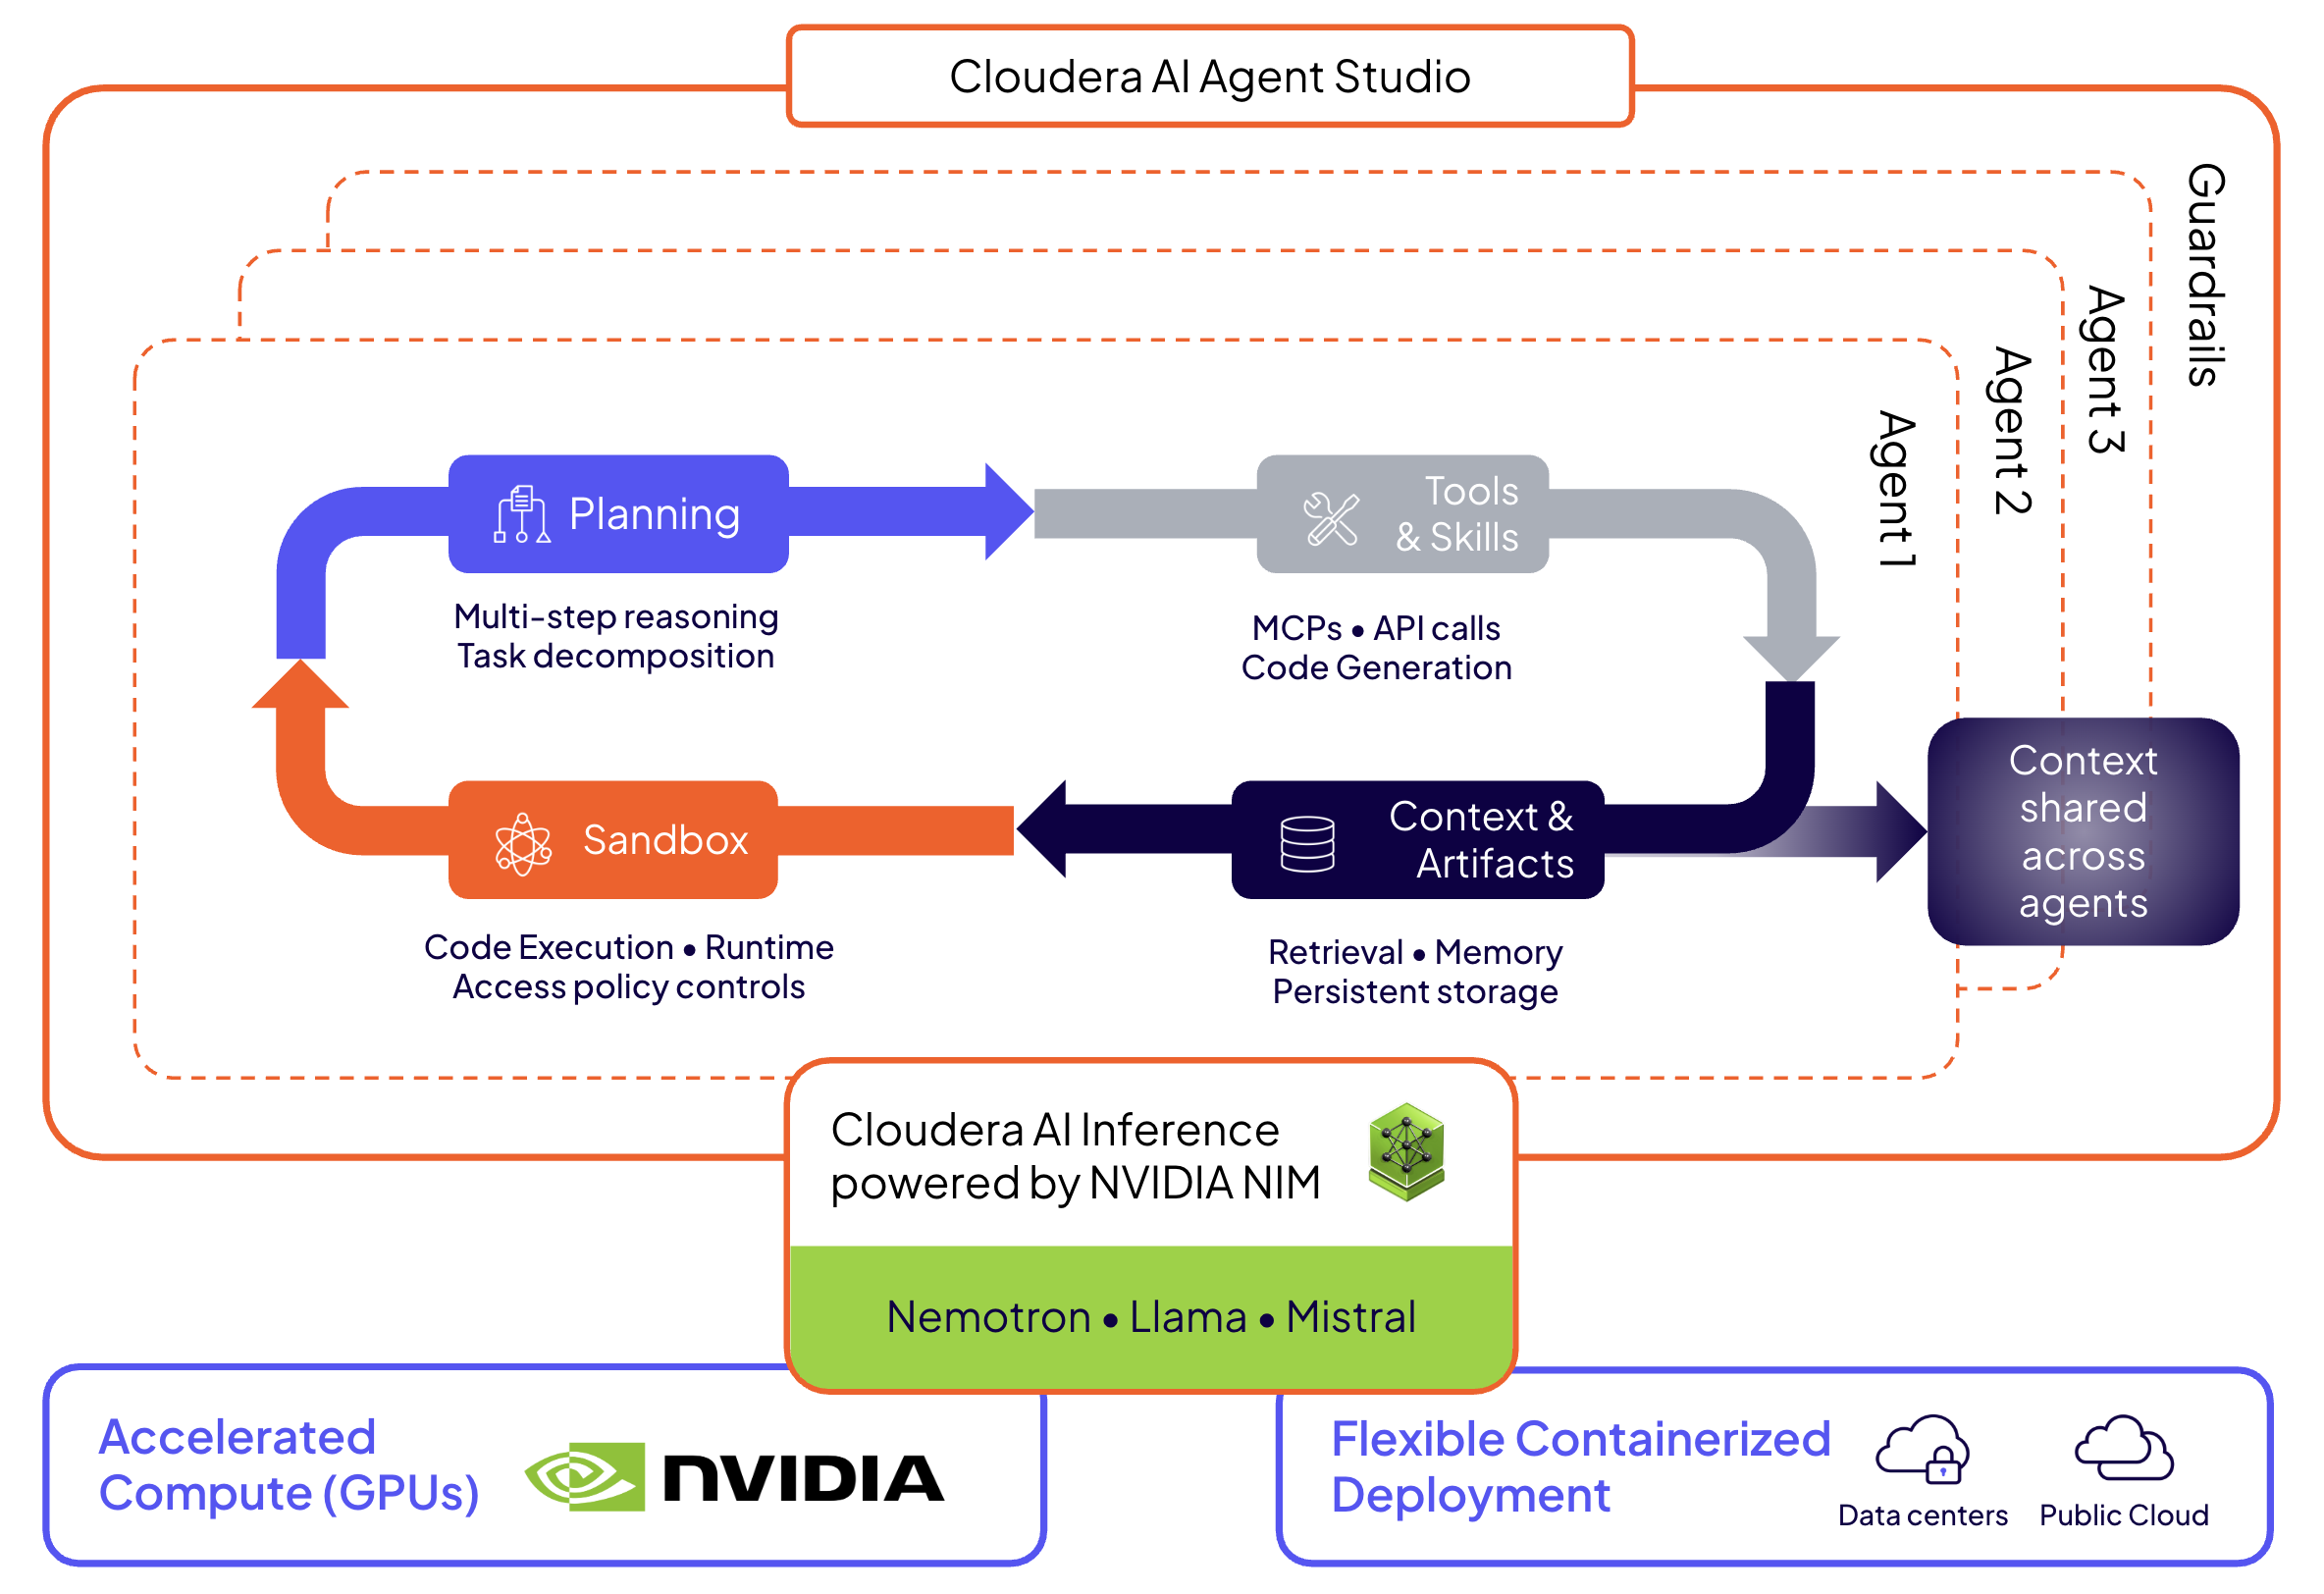 Arquitectura de Agent Studio 3.0
Cloudera Agent Studio 3.0 resuelve estos retos estructurales ejecutando flujos de trabajo autónomos de IA directamente donde residen tus datos. Al ofrecer un motor de ejecución gobernado que funciona sobre las bases de los servicios de datos existentes de Cloudera, elimina sistemáticamente cada una de las cinco barreras estructurales:
1. Registros de auditoría inmutables y controles
Resolver la autonomía de caja negra y las responsabilidades de auditoría
Para mitigar el riesgo normativo y eliminar la ejecución de tipo caja negra, los registros de actividad del sistema se almacenan en registros de auditoría estructurados y de solo adición. Los equipos de cumplimiento normativo obtienen una visibilidad integral, ya que se registran las identidades de los usuarios autenticados, las marcas de tiempo con precisión de microsegundos, los tipos de operación, los identificadores de recursos, las instrucciones y los resultados específicos de las herramientas.
Vea: controles en tiempo real en acción
La seguridad de la ejecución se garantiza de forma continua mediante los siguientes mecanismos en tiempo real:
Enmascaramiento de PII: Anonimiza los datos sensibles antes de transmitirlos a la ventana de contexto del modelo.
Filtros de contenido: reglas deterministas basadas en texto que protegen contra la inyección de prompts o bloquean la ejecución en función de palabras clave.
Evaluador LLM integrado: valida las entradas y salidas de las cargas útiles de las herramientas conforme a las normas de cumplimiento corporativo.
Control personalizado: hace cumplir mediante programación los controles adaptados a los requisitos de su empresa.
Para más información, consulte nuestra documentación de Guardrails.
2. Flujos de trabajo unificados de doble vía
Solucionar la falta de coherencia en el gobierno entre equipos aislados
Agent Studio 3.0 unifica el desarrollo técnico y no técnico en un único motor de orquestación, salvando la brecha arquitectónica entre los equipos de negocio y de ingeniería:
Para analistas de negocio: Cree flujos de trabajo de forma visual con un catálogo de plantillas de herramientas prediseñadas y conectores MCP.
Para ingenieros de IA: Escriba lógica personalizada en Python en Cloudera AI Workbench.
Como ambas rutas se compilan en entornos de ejecución idénticos, comparten los mismos controles de seguridad de la plataforma y eliminan las desviaciones en el gobierno de la IA en la sombra.
3. Llamadas a funciones controlables y aislamiento en entornos de pruebas
Solucionar la fragilidad de las instrucciones y los reintentos de ejecución
Para eliminar las cadenas de ejecución frágiles de las instrucciones de texto, la plataforma aprovecha los protocolos nativos de llamada a funciones de los LLM. Pasa esquemas JSON formales al modelo para generar objetos de llamada a herramientas fuertemente tipados.
Aislamiento de contenedores: cada proceso de agente se ejecuta dentro de entornos de pruebas aislados en contenedores, configurados sin permisos del sistema por defecto, lo que requiere la aprobación explícita de las políticas a nivel de plataforma para escalar privilegios.
Planificación estructurada: antes de la ejecución, los agentes elaboran un plan de tareas estructurado para que los operadores puedan supervisar de forma determinista el progreso paso a paso.
4. Computación localizada sobre datos gestionados mediante MCP
Solucionar los costes de salida de la nube y la inflación de tokens
Los agentes ejecutan operaciones directamente sobre el almacenamiento empresarial sin extraer ni replicar datos. Los agentes consultan datos analíticos estructurados en Cloudera Data Warehouse, procesan datos de entrada en streaming mediante Cloudera DataFlow y envían los resultados a Cloudera Data Visualization.
Los conectores que utilizan Model Context Protocol (MCP) vinculan los agentes directamente con formatos de tablas abiertas, mientras que las políticas de gobierno de Cloudera Shared Data Experience (SDX) aplican controles de acceso basados en roles y realizan un seguimiento de los metadatos en cada interacción, lo que mantiene los datos fundamentados y las tarifas de salida de datos en cero.
5. Neutralidad de modelos y control de FinOps
Resolver la dependencia de las API y los costes fijos de computación
Agent Studio 3.0 separa por completo la orquestación de los modelos de lenguaje subyacentes. Los equipos pueden utilizar API de terceros (OpenAI, Anthropic, Amazon Bedrock) o implementar modelos de código abierto localmente a través del servicio Cloudera AI Inference.
Cambiar los modelos de destino requiere actualizar las configuraciones de los puntos de conexión en la capa de orquestación sin modificar el código de los agentes ni los esquemas de las herramientas. Los arquitectos de sistemas reducen el coste total de propiedad (TCO) al dirigir las llamadas a funciones rutinarias y de gran volumen a modelos con menos parámetros alojados localmente y reservar los costosos tokens de API de terceros estrictamente para el razonamiento complejo de varios pasos.
Resultados empresariales cuantificados
Sector |
Escenario operativo |
Valor de negocio |
Servicios financieros |
Evalúe cuentas comerciales con historial crediticio limitado en conjuntos de datos que superan los 100 millones de registros. |
Reduce los ciclos de evaluación de riesgos de días a minutos mientras genera registros de auditoría listos para los organismos reguladores. |
Telecomunicaciones |
Procesa más de 50 000 eventos en transmisión por segundo a través de Data Flow para detectar señales de pérdida de clientes. |
Activa flujos de trabajo automatizados de retención en tiempo real sin sacar los datos de los sistemas operativos. |
Sanidad y ciencias biológicas |
Extraiga códigos de diagnóstico de documentos clínicos no estructurados de distintos registros médicos. |
Acelera el procesamiento de datos de ensayos clínicos en tiempos de ejecución aislados. |
Seguros |
Correlacione los estudios de campo no estructurados de emplazamientos inmobiliarios con las bases de datos transaccionales principales. |
Identifica los factores de riesgo omitidos y automatiza la conciliación de datos entre sistemas. |
Software y tecnología |
Realiza la clasificación de incidentes de producción de nivel 2 en tiempos de ejecución de contenedores aislados. |
Resuelve las alertas de las aplicaciones y actualiza los parámetros del estado del sistema sin necesidad de escalar el caso a un agente humano. |
Tu futuro con IA agéntica y gobernada
Pasar los flujos de trabajo autónomos de prototipos aislados a sistemas de producción requiere resolver la fricción entre la innovación rápida y el control empresarial. Durante demasiado tiempo, la brecha entre la prueba de concepto y la implementación ha obligado a los equipos a elegir entre la agilidad de la IA autónoma y la seguridad del gobierno centralizado.
Cloudera Agent Studio 3.0 cierra esta brecha.
Al ejecutar la computación directamente donde residen los datos, Agent Studio 3.0 desmantela de forma sistemática los cinco principales obstáculos para la IA en entorno de producción: los costes de salida de la nube, la fragilidad de la ejecución, la desviación del gobierno, la ambigüedad en las auditorías y la dependencia de una plataforma de cómputo. Implementar IA agéntica empresarial ya no implica tener que hacer concesiones en la arquitectura.
¿Todo listo para poner en marcha tus agentes de IA? Descubre las estrategias y habilidades necesarias para pasar del desarrollo a la producción en nuestra serie de webinars de 7 entregas sobre IA empresarial y agéntica.